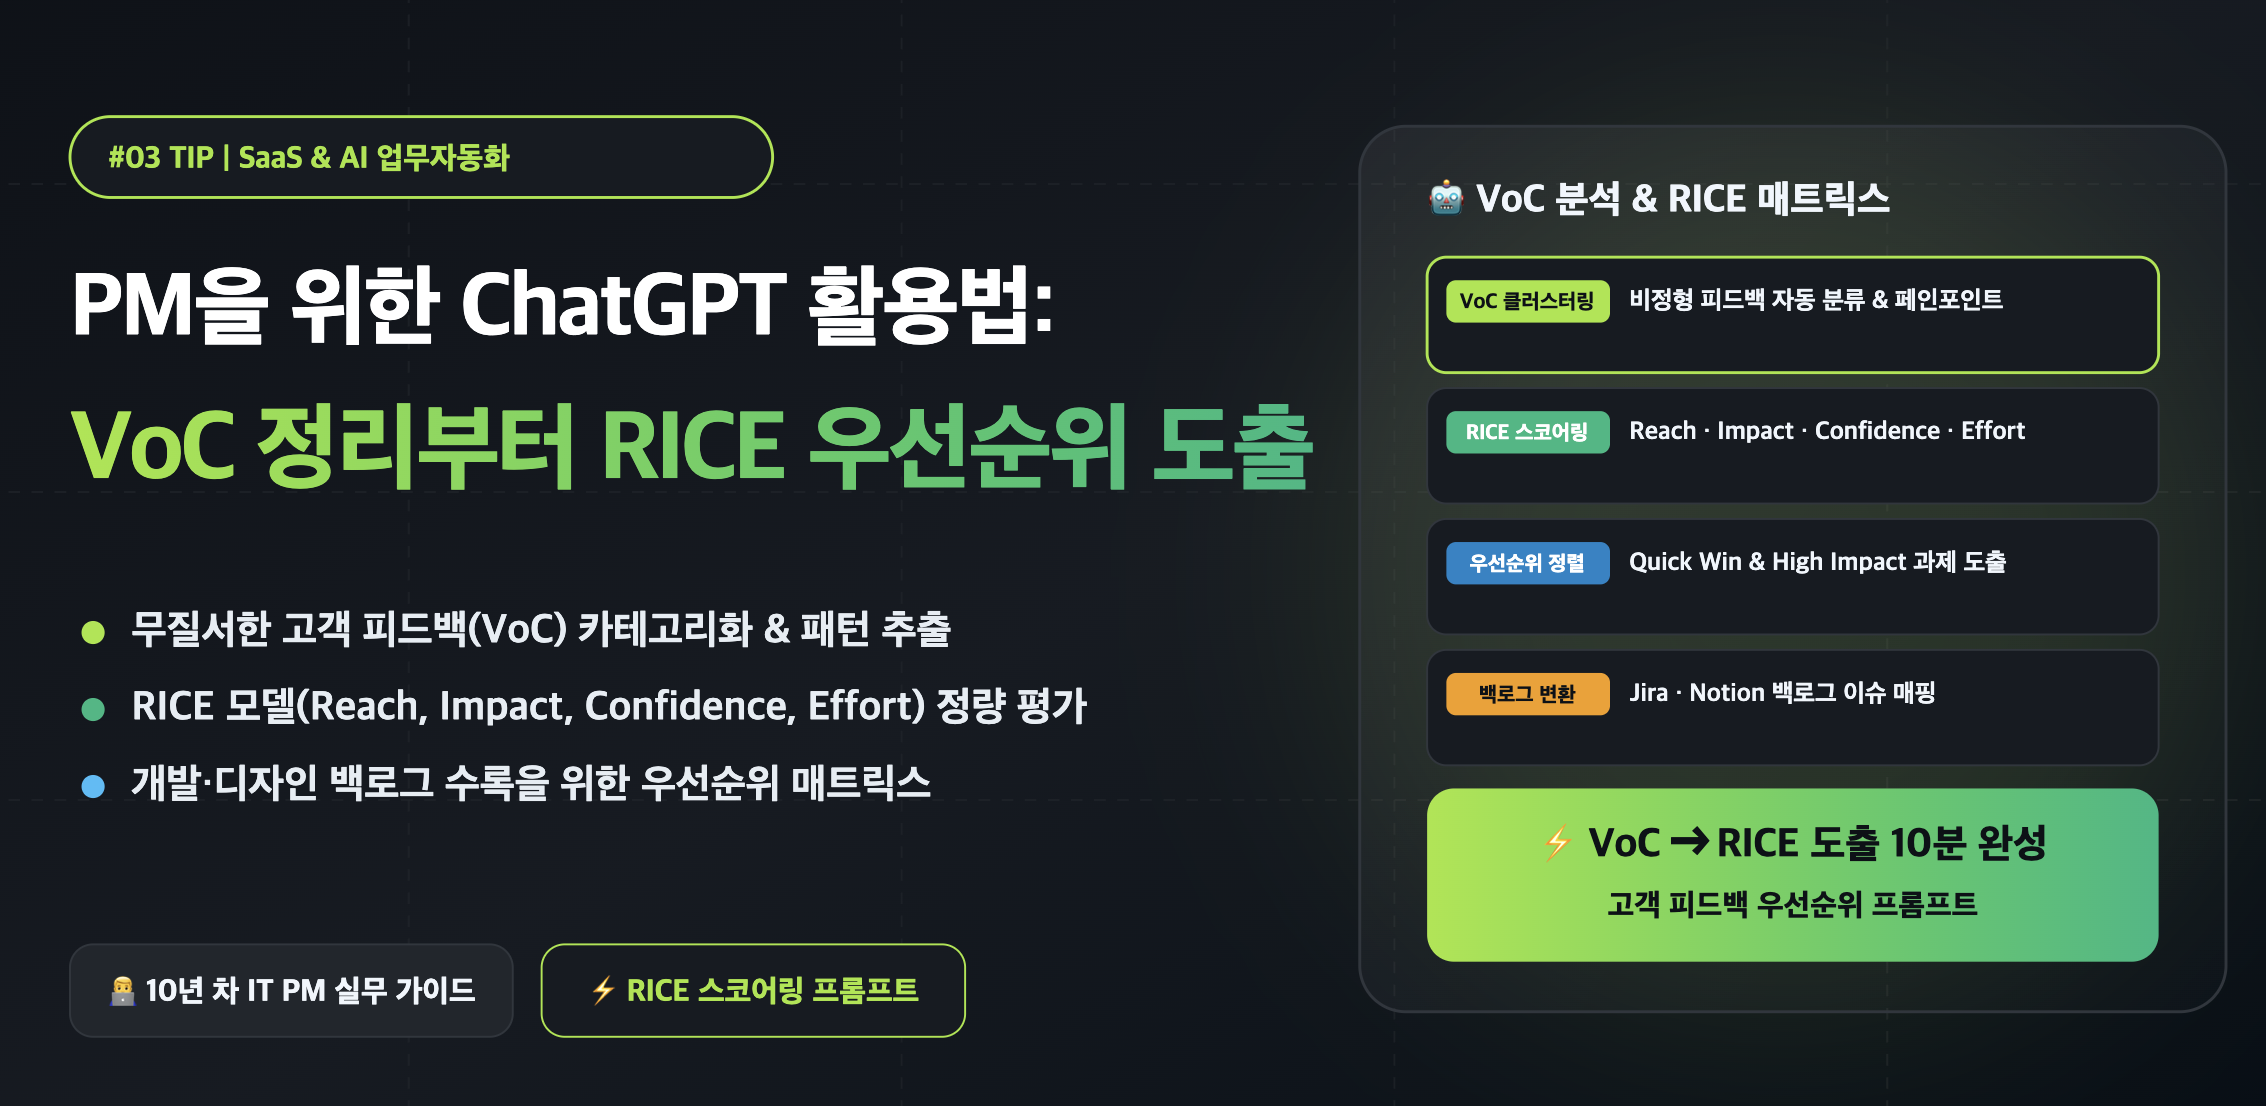
앱 마켓 리뷰, CS 문의 내역, 유저 인터뷰 기록 등 수백 건의 무질서한 고객 피드백(VoC)을 엑셀에 모아두고 일일이 읽으며 정렬하는 것은 PM의 리소스를 크게 갉아먹는 작업입니다. 피드백을 주관적으로 해석하다 보면 “가장 목소리가 큰 고객”의 요구나 “최근에 접수한 단 한 건의 불편”에 휘둘려 정작 중요한 비즈니스 문제 해결을 놓치기 쉽습니다.
50여 개 대형 IT 프로젝트 현장에서 수만 건의 VoC 데이터를 다뤄온 ChatGPT 활용 VoC 그룹화, 핵심 문제 정의 및 RICE 프레임워크 기반 우선순위 10분 추출 프롬프트 체계를 정리합니다.
VoC 분석 및 우선순위 결정 방식 비교
| 구분 | 수동 VoC 분석 (Traditional) | ChatGPT & RICE 프롬프트 활용 (AI-Assisted) |
| 분석 소요 시간 | 100건 기준 평균 3시간 ~ 5시간 소요 | 100건 데이터 입력 후 5분 ~ 10분 이내 완료 |
| 문제 그룹화 | PM의 주관적 감에 의존해 카테고리 분류 | 유저 페인 포인트(Pain Point) 기준 객관적 클러스터링 |
| 우선순위 산정 | 직관이나 C-Level의 단발성 요청에 좌우됨 | RICE Formula(Reach, Impact, Confidence, Effort) 수치화 |
| 백로그 연결성 | 피드백과 실제 기획 가설 간 격차 발생 | VoC $\rightarrow$ 문제 정의 $\rightarrow$ 개선 가설 $\rightarrow$ 백로그 즉시 전환 |
1. VoC 분석 및 RICE 우선순위 추출 만능 메가 프롬프트
수집된 정성적 VoC 텍스트 데이터를 통째로 복사해 ChatGPT에 아래 프롬프트와 함께 입력하면, 정제된 문제 정의와 정량화된 RICE 점수표가 즉시 도출됩니다.
[역할 정의]
너는 10년 차 수석 프로덕트 매니저(PM)이자 데이터 기반 UX 리서처야.
무질서한 고객 피드백(VoC) 텍스트 데이터를 분석하여 유저의 핵심 페인 포인트(Pain Point)를 그룹화하고, 이를 해결하기 위한 개선 가설 및 RICE 우선순위 평가표를 작성하는 것이 너의 목적이야.

[수집된 VoC 데이터]
---
[여기에 앱 리뷰, CS 문의 내역, 유저 인터뷰 텍스트 복사-붙여넣기]
(예: "결제 버튼 누르면 자꾸 흰 화면만 나와요", "쿠폰 어디서 적용하는지 찾기 너무 힘들어요", "주문 내역 조회에서 지난 달 내역이 안 떠요" 등)
---

[분석 및 RICE 추출 요구사항]
다음 단계에 따라 결과를 출력해줘:

1. VoC 핵심 문제 클러스터링 (Problem Clustering)
   - 유사한 피드백끼리 묶어 상위 3~5개 핵심 문제 카테고리로 분류
   - 각 카테고리별 대표 VoC 요약 및 유저 페인 포인트 명시

2. 문제 해결을 위한 개선 가설 (Product Hypotheses)
   - 각 문제 카테고리별로 "만약 우리가 [해결책]을 적용한다면, [지표/경험]이 개선될 것이다" 포맷의 가설 작성

3. RICE 프레임워크 기반 우선순위 매트릭스 (RICE Score Matrix)
   - 아래 RICE 산식 수식을 적용해 각 가설별 점수를 계산하고 표(Table)로 정리할 것:
     * RICE Score = (Reach x Impact x Confidence) / Effort
   - 평가 기준:
     * Reach (영향받는 유저 비율/수): 1점(소수) ~ 10점(전체 유저)
     * Impact (유저 경험/매출 개선 폭): 0.5(미비), 1(보통), 2(큼), 3(매우 큼)
     * Confidence (가설의 확신도): 50%(low), 80%(medium), 100%(high - 데이터 근거 명확)
     * Effort (개발/디자인 공수 - 인월/주 단위): 1점(1주 이내) ~ 5점(1개월 이상)

4. Top 1 추천 백로그 및 액션 플랜 (Actionable Next Step)
   - RICE 점수가 가장 높은 1순위 과제에 대한 즉각적인 개선 액션 아이템 명시
2. RICE 프레임워크 산식과 AI 양형 기준 파악하기
ChatGPT가 도출하는 RICE 점수를 실무진이 납득할 수 있게 만들려면 RICE의 4가지 구성 요소를 정밀하게 제어해야 합니다.
$$\text{RICE Score} = \frac{\text{Reach} \times \text{Impact} \times \text{Confidence}}{\text{Effort}}$$
- Reach (도달 범위): 해당 문제로 인해 불편을 겪는 유저의 비율입니다. 결제 단계 오류처럼 전체 유저가 거치는 플로우라면 높은 점수(8~10점)를 부여합니다.
- Impact (영향도): 문제 해결 시 결제 전환율(CVR)이나 이탈률 방어에 얼마나 기여하는지 평가합니다.
- Confidence (신뢰도): 정량 데이터(GA4, DB 로그)나 다수의 VoC로 뒷받침되는지 여부입니다. 단순 1건의 주관적 피드백이라면 50%, 명확한 데이터 로그가 있다면 100%를 적용합니다.
- Effort (공수/노력): 분모에 위치하므로, 개발 및 디자인 공수가 적게 들수록 RICE 총점이 올라가 빠르게 실행(Quick Win)할 수 있는 과제로 분류됩니다.
3. 대용량 VoC 노이즈 제거 및 데이터 정제 튜닝 프롬프트 3선
원문 데이터의 양이 너무 많거나 잡음(단순 불평, 시스템과 무관한 글)이 섞여 있을 때 활용하는 보조 프롬프트입니다.
- 노이즈 필터링 프롬프트: “위 VoC 데이터 중 서비스 기능 개선과 무관한 단순 감정적 비난이나 배송/외부 협력사 관련 불만은 제외하고, 시스템 UI/UX 및 기능 오류에 해당하는 건만 선별해 줘.”
- 데이터 비중 시각화 프롬프트: “분류된 각 문제 카테고리별로 전체 VoC에서 차지하는 비율(%)을 계산하여 가장 빈도가 높은 순서대로 정렬해 줘.”
- Jira 티켓 변환 프롬프트: “RICE 점수 1위로 산출된 개선 가설을 지라(Jira)에 즉시 등록할 수 있도록 [이슈 제목 / 설명 / 수용 기준(AC)] 양식으로 변환해 줘.”
4. 10년 차 PM이 전하는 RICE 점수 검증 실무 팁
ChatGPT가 훌륭하게 VoC를 클러스터링하고 RICE 초안을 잡아주더라도, ‘Confidence(신뢰도)’와 ‘Effort(공수)’ 값은 PM이 직접 검수해야 합니다.
- Effort(공수)는 테크 리드와 상의: AI는 내부 레거시 코드나 DB 구조를 알지 못하므로, AI가 산정한 Effort 점수를 개발팀 테크 리드에게 보여주고 “이 공수 산정이 실제 스쿼드 상황에 맞는지” 체크해야 합니다.
- Quick Win 과제 선별: RICE 점수가 높으면서 Effort가 1~2점으로 낮은 과제(Quick Win)를 스프린트에 즉시 포함시키면, 적은 공수로 유저 만족도를 빠르게 올리는 성과를 낼 수 있습니다.
[7tipbox 요약]
VoC 분석과 우선순위 결정의 핵심은 무질서한 고객 피드백을 개인의 감으로 다루지 않고 'RICE 프레임워크(Reach, Impact, Confidence, Effort)'로 정량화하는 데 있습니다.
ChatGPT 메가 프롬프트를 활용해 10분 만에 수백 건의 피드백을 유저 페인 포인트별로 클러스터링하고, 도출된 RICE 점수를 바탕으로 개발팀·데이터 분석가와 공수를 검수하여 백로그로 전환하는 것이 50개 이상의 대형 프로젝트를 성공으로 이끈 10년 차 IT PM의 실무 방정식입니다.